
KI Stimmen erstellen: Workflow für natürliche Voice-Agenten
KI Stimmen erstellen für den Unternehmenseinsatz: Ein praxisnaher Workflow von der Aufnahme über das Feintuning bis zur rechtssicheren Integration
Die beliebteste Empfehlung zum Thema KI-Stimmen erstellen lautet: Die Stimme muss so menschlich wie möglich klingen. Für B2B-Telefonie halte ich das für den falschen Startpunkt. Eine Stimme, die menschliche Täuschung verspricht, aber bei Namen, Zahlen, Pausen oder Einwänden aus dem Takt gerät, zerstört Vertrauen schneller als eine klar erkennbare, kompetente KI-Stimme.
In produktiven Telefonagenten zählen andere Eigenschaften: verständliche Aussprache, konsistentes Verhalten, kurze Reaktionszeiten, saubere Übergaben und transparente Kommunikation. Sprachinteraktion ist in Deutschland längst kein exotisches Bedienkonzept mehr. Laut Bitkom nutzten 2024 53 Prozent der Bevölkerung ab 16 Jahren zumindest gelegentlich Sprachassistenten. Das schafft eine gute Grundlage für Voice-Agenten, ersetzt aber keine saubere Entwicklung und Prüfung.
Warum perfekte Täuschung im B2B-Kontext scheitert
Eine möglichst menschliche KI-Stimme ist im B2B-Vertrieb kein verlässliches Qualitätsziel. Im produktiven Telefonagenten zeigt sich der Unterschied bei Firmennamen, Abkürzungen, Zahlen, Pausen und Unterbrechungen. Wird eine Silbe falsch betont oder eine bereits beantwortete Frage wiederholt, entsteht schnell der Eindruck mangelnder Sorgfalt.
Anrufer bewerten, ob ihr Gegenüber zuverlässig zuhört, Informationen korrekt verarbeitet und den nächsten Schritt sicher führt. Ein warmer, realistischer Klang hilft wenig, wenn die Gesprächslogik schwankt oder Einwände unpassend beantwortet werden.
Praktische Regel: Optimiere auf erwartbares Verhalten in realen Gesprächssituationen. Transparenz, reproduzierbare Tests und sauber gesetzte Grenzen schaffen mehr Vertrauen als perfekte Täuschung.
Was Geschäftsanrufer tatsächlich brauchen
Bei Lead-Qualifizierung und Terminvereinbarung ist eine klar erkennbare KI-Stimme kein automatischer Nachteil. Die Ansage zur digitalen Unterstützung setzt eine passende Erwartung. Danach zählt, ob der Agent Klarheit, Geschwindigkeit und Zielerreichung liefert.
Ein belastbares Business-Stimmenprofil umfasst:
- Klarheit: Fachbegriffe, Namen, Zahlen und Termine werden stabil ausgesprochen.
- Konsistenz: Tonfall und Energie bleiben über mehrere Gesprächsabschnitte hinweg kontrolliert.
- Gesprächsführung: Die Stimme stellt eine Frage, wartet auf die Antwort und führt gezielt weiter.
- Unterbrechbarkeit: Korrekturen und Zwischenfragen bringen den Gesprächsfaden nicht aus dem Takt.
- Transparenz: Die KI-Nutzung wird verständlich angekündigt, ein menschlicher Kontakt bleibt erreichbar.
Diese Anforderungen passen zur wachsenden Vertrautheit mit Sprachinteraktion in Deutschland. Laut Bitkom zur Nutzung von Sprachassistenten nutzten 62 Prozent der Bevölkerung Sprachassistenten; 78 Prozent der Nutzer setzten sie zum Starten von Anrufen ein. Gewöhnung an sprachbasierte Kommunikation ersetzt jedoch keine Prüfung von Aussprache, Unterbrechungen und Übergaben.
Conversion entsteht durch Verlässlichkeit
Conversion entsteht, wenn die Stimme Reibung aus dem Prozess entfernt: durch eine eindeutige Begrüssung, passende Rückfragen, verständliche Antworten auf Einwände und eine Terminvereinbarung ohne Medienbruch. Jede dieser Stellen lässt sich im Testfall prüfen und mit wiederholbaren Kriterien bewerten.
Wer die Stimme in eine wirksame B2B Marketing Strategie aufbauen einordnet, betrachtet deshalb auch Positionierung, Angebot und Vertriebsprozess. Eine markante, transparente Stimme kann im Gespräch überzeugender arbeiten als ein künstlich perfekter Menschenersatz.
Aufnahme und Datenvorbereitung für das Voice-Cloning
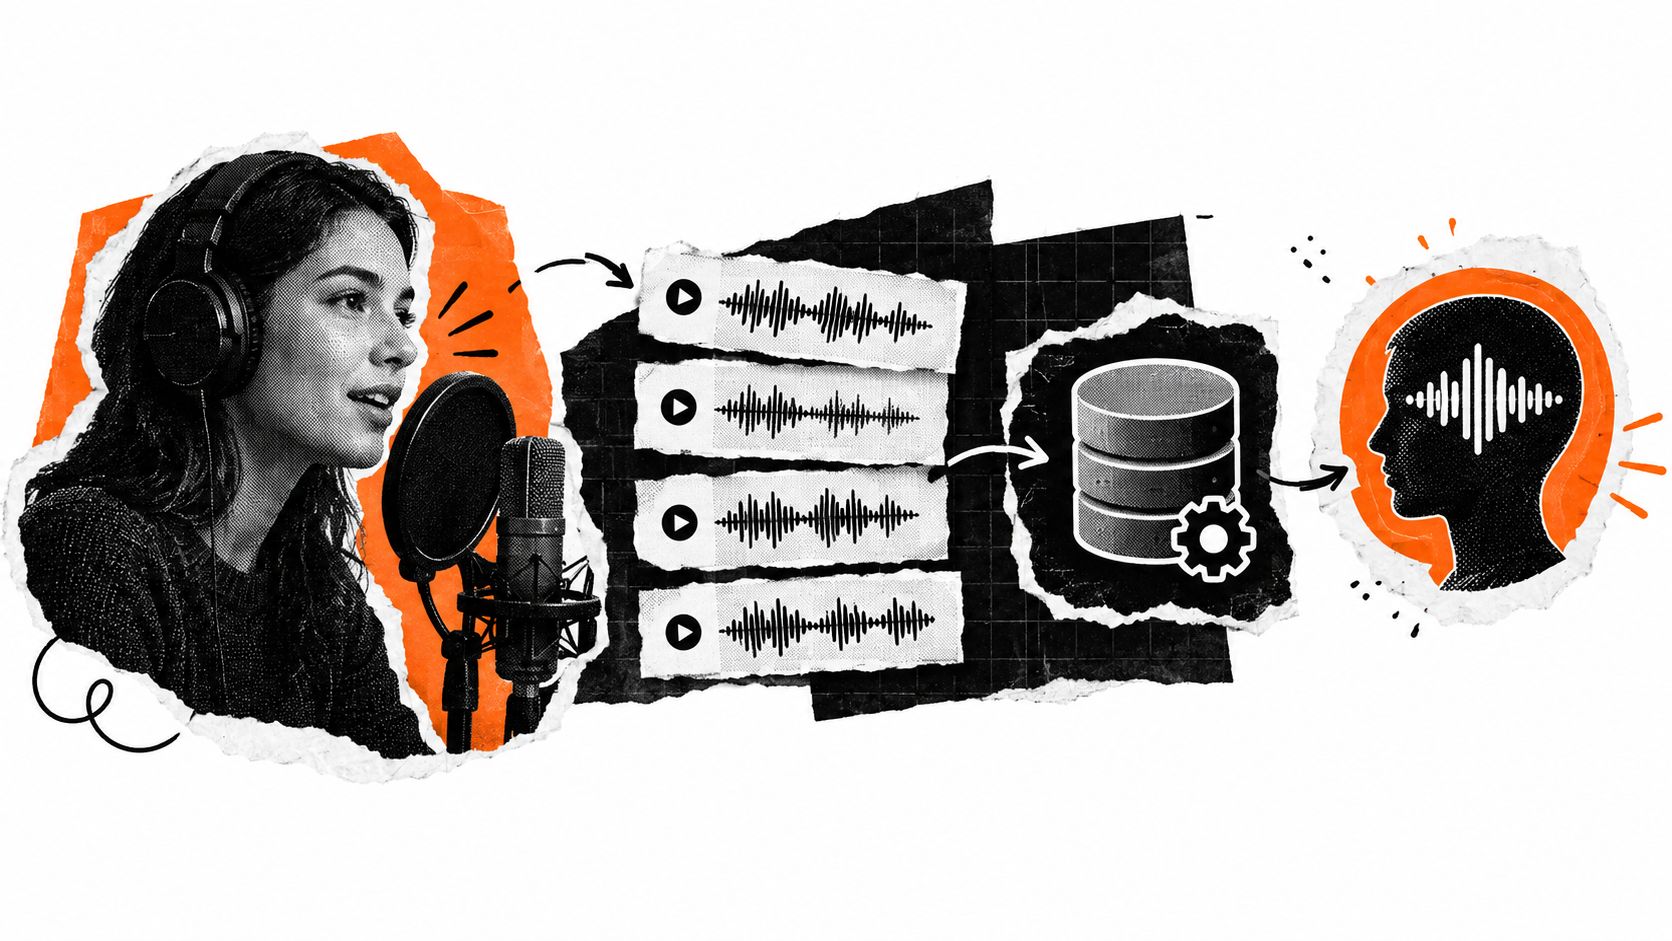
Beim Voice-Cloning entscheidet die Datenbasis über weit mehr als den Stimmklang. Ein Modell lernt nicht nur die Tonhöhe einer Sprecherin oder eines Sprechers. Es übernimmt auch Sprechtempo, Pausen, Energie, Aussprachegewohnheiten und die Art, wie Satzenden gestaltet werden.
Für Telefonie braucht es deshalb kein beliebiges Vorlesematerial. Es braucht Aufnahmen, die den späteren Einsatz abbilden. Ein sauber gesprochenes Hörbuchkapitel kann für eine Hotline weniger nützlich sein als kurze, kontrollierte Dialogsätze mit Begrüssungen, Rückfragen, Zahlen und Einwänden.
Zuerst das Sprecherprofil festlegen
Vor jeder Aufnahme sollte ein schriftliches Profil stehen. Darin werden die Grenzen der Stimme definiert, damit Training und spätere Tests auf dasselbe Ziel einzahlen.
| Merkmal | Entscheidung für das Profil |
|---|---|
| Alterseindruck | sachlich, nahbar oder seniorig |
| Regionale Färbung | neutrales Standarddeutsch oder klar begrenzte regionale Färbung |
| Sprechtempo | ruhig, zügig oder bewusst moderat |
| Energie | zurückhaltend, beratend oder vertriebsorientiert |
| Pausenstil | kurz zwischen Fragen, länger vor wichtigen Informationen |
| Emotion | freundlich und souverän, ohne dramatische Ausschläge |
Die emotionale Bandbreite sollte begrenzt bleiben. Ein Telefonagent für Terminvereinbarung braucht keine Schauspielperformance. Zu viel Begeisterung wirkt bei einem Einwand schnell aufgesetzt, während zu wenig Variation monoton und unaufmerksam klingt.
Dialogdaten statt stundenlangem Vorlesen
Nimm gezielt Sätze auf, die im Produktivbetrieb vorkommen. Dazu gehören:
- Begrüssungen und Hinweise zur KI-Nutzung
- Namen von Produkten, Unternehmen und Ansprechpartnern
- Datumsangaben, Uhrzeiten und Telefonnummern
- Abkürzungen aus der Branche
- Rückfragen zur Qualifizierung
- typische Einwände wie fehlendes Interesse oder ein späterer Rückruf
- Übergaben an Mitarbeitende
- Bestätigungen von Terminen und Kontaktdaten
Die Texte sollten phonetisch ausgewogen sein. Kurze Wörter testen harte Konsonanten, längere Sätze prüfen den Atem- und Pausenfluss. Eigennamen zeigen, ob die Stimme mit unbekannten Schreibweisen umgehen kann. Zahlen und Datumsangaben müssen separat getestet werden, weil ein Modell sie nicht zwangsläufig so interpretiert, wie ein Mensch sie im Geschäftsalltag ausspricht.
Akustische Sauberkeit ohne künstliche Perfektion
Der Aufnahmeraum sollte gleich bleiben. Wechselnde Mikrofone, Raumhall oder unterschiedliche Abstände erzeugen Schwankungen, die später wie Stimmeigenschaften wirken können. Hintergrundgeräusche gehören nicht in die Trainingsdaten, wenn sie nicht ausdrücklich Teil des Zielmediums sind.
Gleichzeitig sollte das Signal nicht aggressiv bearbeitet werden. Überkompression kann Transienten und natürliche Lautstärkeunterschiede zerstören. Für einen Agenten, der über Telefonie läuft, muss die Stimme unter realen, begrenzten Übertragungsbedingungen verständlich bleiben. Teste deshalb nicht nur die Studioaufnahme, sondern auch gerenderte Beispiele über die geplante Telefonstrecke.
Für Transkription und nachgelagerte Auswertung kann eine Lösung wie KI-Audio-zu-Text hilfreich sein. Wichtig bleibt, dass die Transkription nicht als Qualitätsbeweis der Stimme missverstanden wird. Ein System kann Text korrekt erkennen, während Menschen die Stimme wegen falscher Betonung oder zu kurzer Pausen als anstrengend wahrnehmen.
Training, Feintuning und akustische Gestaltung
Nach der Datenvorbereitung beginnt die eigentliche Steuerungsarbeit. Viele Teams versuchen, jede Unsauberkeit mit einem allgemeinen Prompt zu lösen. Das funktioniert selten dauerhaft. Ein Sprecherprofil, feste Textregeln und gezielte Aussprachekorrekturen liefern eine stabilere Grundlage.
Das Profil sollte konkrete Grenzen enthalten: gewünschtes Tempo, Energie, Pausenverhalten, regionale Färbung und zulässige Emotion. Formulierungen wie „freundlich und natürlich“ sind zu unpräzise. Besser ist eine Beschreibung wie: „Ruhig, verbindlich, kurze Pausen nach Fragen, keine übertriebene Begeisterung, wichtige Termine leicht betonen.“
Aussprache systematisch korrigieren
Deutsche Stimmen zeigen ihre Schwächen oft bei Abkürzungen, Eigennamen, Datumsangaben und zusammengesetzten Fachbegriffen. Eine Schreibweise, die für Menschen eindeutig ist, muss für die Sprachsynthese nicht eindeutig sein. Deshalb braucht jedes produktive Projekt eine Ausspracheliste.
Darin stehen das problematische Wort, die gewünschte phonetische Schreibweise und der Kontext, in dem die Korrektur gilt. Je nach System kommen zusätzlich SSML-Regeln für Betonung, Pausen oder Sprechtempo zum Einsatz. Auch die Segmentierung hilft: Ein langer Satz mit mehreren Nebensätzen kann verständlicher werden, wenn er in kurze, logisch getrennte Einheiten zerlegt wird.
Was nicht funktioniert: Eine einzelne korrigierte Audiodatei zu hören und daraus auf die gesamte Stimme zu schließen. Jede Änderung muss in mehreren Kontexten geprüft werden.
Das Forschungsprojekt DÍSTRAL benennt Defizite bei Aussprache, Emotion, Dialektvielfalt und klanglicher Nuance als Hürden für hochwertige Anwendungen. Diese Punkte hängen zusammen. Eine Stimme kann ein Wort korrekt aussprechen und trotzdem unnatürlich wirken, wenn die Betonung nicht zum Satzsinn passt.
Jede Änderung braucht einen Regressionstest
Prompt- oder SSML-Änderungen können an einer Stelle helfen und an einer anderen Stelle neue Fehler erzeugen. Deshalb sollte vor jeder Anpassung ein festes Testkorpus gerendert werden. Das Korpus enthält kritische Namen, Zahlen, Begrüssungen, Fragen, Einwände und Übergaben.
Ein praktikabler Vergleich besteht aus drei Varianten pro kritischem Satz:
- der bisherigen Version,
- der geänderten Version,
- einer alternativen Segmentierung oder phonetischen Schreibweise.
Bewertet werden nicht nur Klang und Natürlichkeit. Entscheidend sind Verständlichkeit, korrekte Entitätenerkennung, Pausen, Unterbrechbarkeit und die Stabilität über mehrere Dialogverläufe. Die Version mit der schönsten Einzelzeile ist nicht automatisch die beste für den Agenten.
Qualitätssicherung und realistische Hörtests
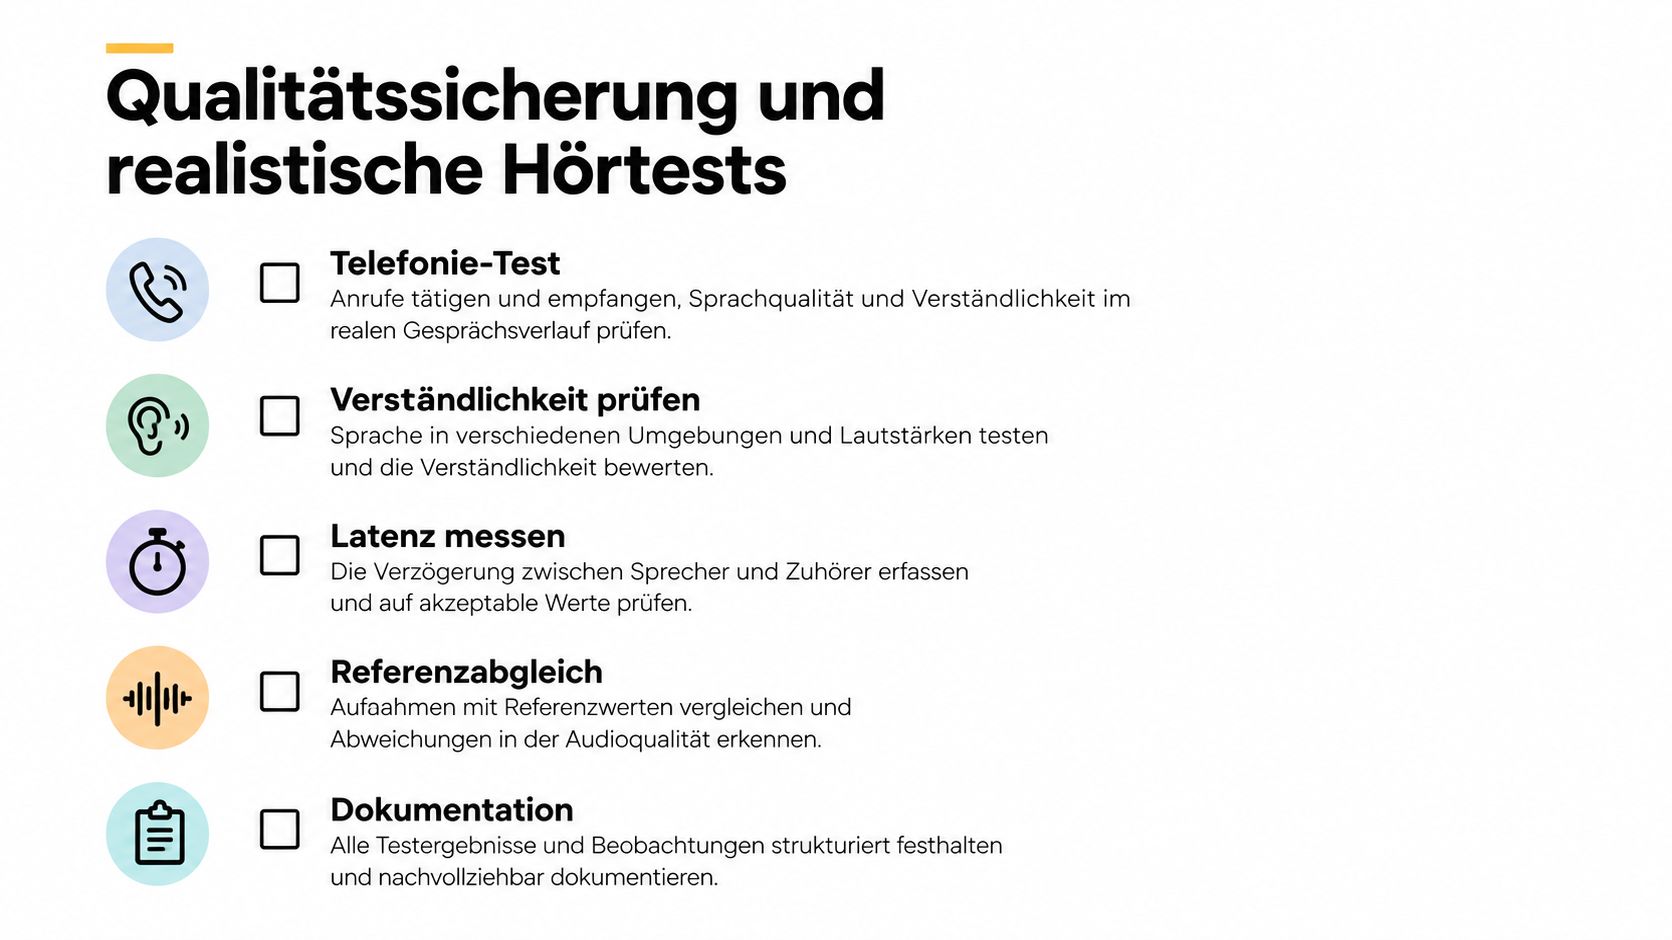
Eine Stimme, die im Texteditor überzeugend klingt, kann im Telefonat unverständlich werden. Telefonie verändert den Höreindruck, und Gesprächsteilnehmende hören nicht in isolierten Beispielsätzen. Sie reagieren auf Unterbrechungen, Nebengeräusche, Akzente, schlechte Verbindungen und unerwartete Antworten.
Die Qualitätsprüfung sollte deshalb reproduzierbar sein. Das deutsche Forschungsprojekt der Hochschule Hof kombiniert physikalische Messwerte mit Hörerbewertungen. Genau diese Kombination ist für Voice-Agenten sinnvoll, weil kein einzelner Messwert die Gesprächswirkung vollständig abbildet.
Das Testkorpus
Ein gutes Korpus verteilt die Risiken über mehrere Kategorien:
- kurze Wörter und kontrastreiche Lautfolgen
- Zahlen, Datumsangaben und Uhrzeiten
- Eigennamen und Unternehmensbezeichnungen
- Abkürzungen und branchenspezifische Begriffe
- typische Begrüssungen und Rückfragen
- Einwände mit anschließender Reaktion
- Sätze mit Korrekturen und Unterbrechungen
Rendern Sie dieselben Texte mit identischen Parametern. Nur so lässt sich feststellen, ob eine Änderung tatsächlich verbessert oder lediglich einen anderen Eindruck erzeugt. Ein einzelnes Demo-Skript ist kein Test.
Objektive und subjektive Kriterien trennen
Objektive Kriterien beschreiben das Verhalten der Ausgabe. Dazu zählen Pausenlänge, Reaktionsverzögerung, Lautstärkeschwankungen, Abbruchverhalten und die korrekte Aussprache definierter Entitäten. Diese Werte lassen sich kategorisieren und über Versionen hinweg vergleichen.
Subjektive Bewertungen sollten getrennt erfolgen. Hörer beurteilen Natürlichkeit und Verständlichkeit nicht als dasselbe Merkmal. Eine Stimme kann angenehm klingen, aber einen Eigennamen undeutlich aussprechen. Blindvergleiche mit menschlichen Aufnahmen zeigen solche Unterschiede besser als eine offene Demo, bei der die Erwartung an KI bereits die Bewertung beeinflusst.
Die verfügbare Forschung weist darauf hin, dass synthetisches Sprachmaterial bei standardisierten Tests grundsätzlich vergleichbare Ergebnisse liefern kann, einzelne Wörter im direkten Vergleich aber schlechter verstanden werden können. Für den Produktivbetrieb ist daher eine Fehlerauswertung nach Kategorie hilfreicher als eine pauschale Qualitätsnote.
Messbare Praxis: Führe getrennte Listen für Aussprachefehler, Verständnisprobleme, unpassende Pausen, misslungene Unterbrechungen und unerwünschte Emotion.
Monitoring nach dem Go-live
Die Prüfung endet nicht mit der Freigabe. Produktive Gespräche liefern andere Fehlerbilder als Labortests. Dokumentiere problematische Stellen, ordne sie einer Kategorie zu und spiele sie in das Regressionstestset zurück.
Besonders kritisch sind Entitäten. Ein falsch verstandener Firmenname kann die CRM-Zuordnung beschädigen, ein falsch wiederholter Termin kann Vertrauen kosten. Auch eine zu kurze Pause kann dazu führen, dass der Agent eine Antwort abschneidet oder eine Korrektur nicht verarbeitet.
Rechtliche Rahmenbedingungen und der EU AI Act
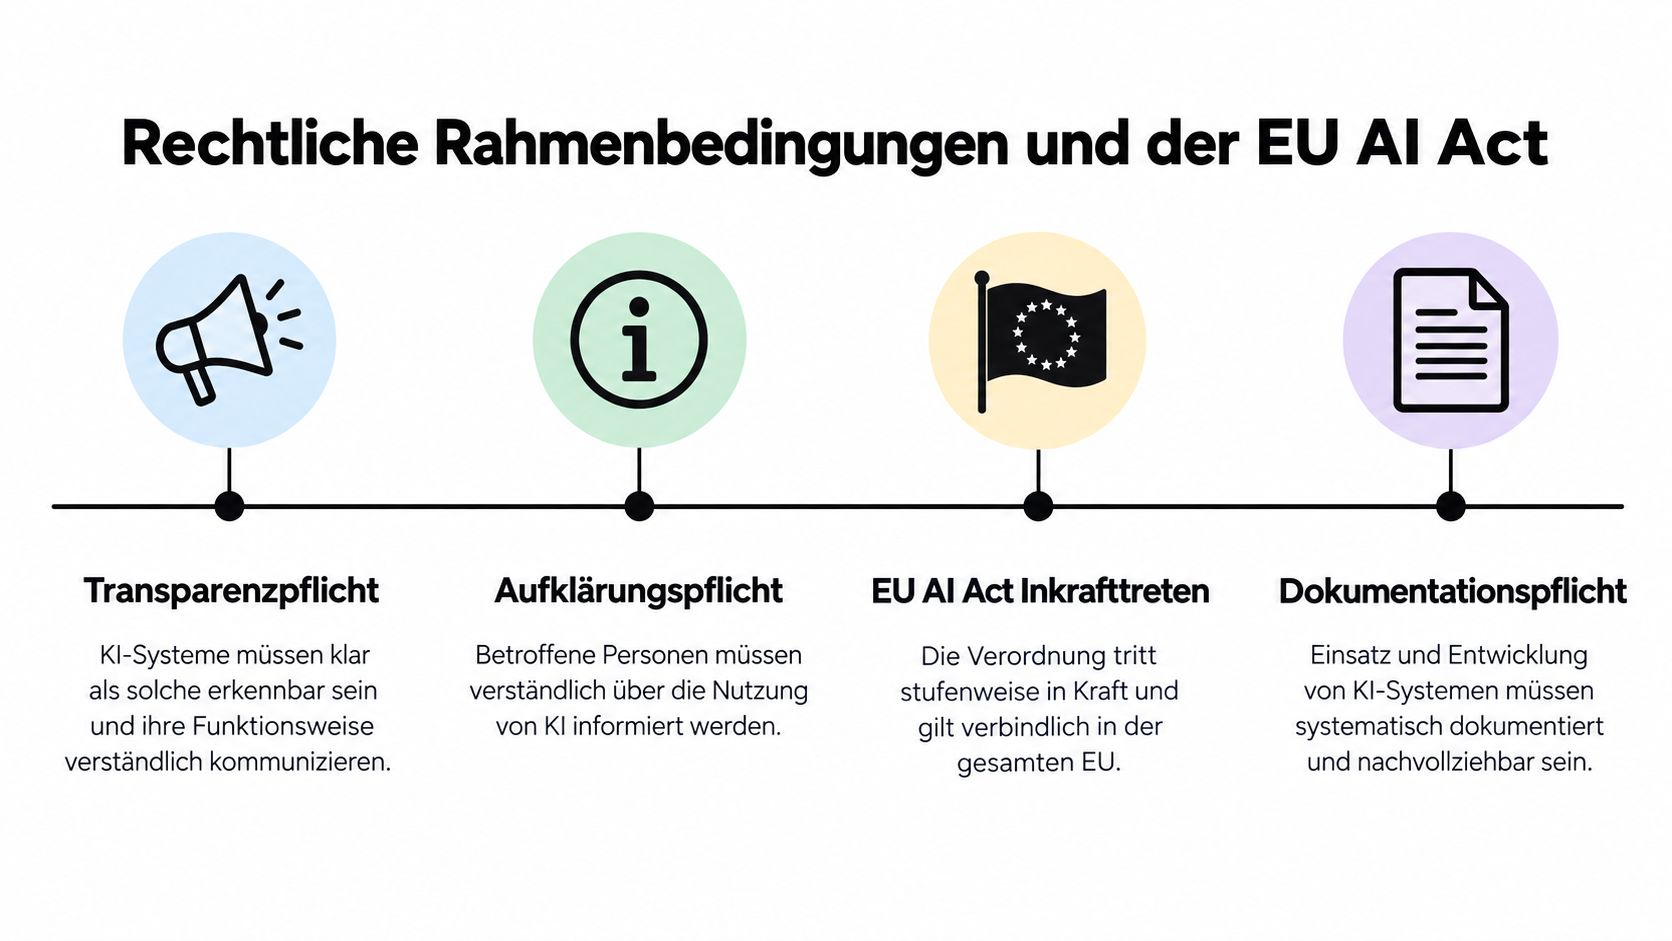
Transparenz gehört beim Erstellen einer KI-Stimme in den Produktanforderungskatalog. Sie ist keine Formulierung, die kurz vor dem Launch ergänzt wird. Wer Disclosure erst nach der technischen Entwicklung plant, muss oft Begrüssung, Gesprächslogik, Eskalation und Dokumentation nachträglich umbauen.
Nach Art. 50 des EU AI Act müssen Menschen erkennen können, wenn sie mit einem KI-System interagieren. Für synthetische Audioinhalte ist zusätzlich eine maschinenlesbare Kennzeichnung vorgesehen. Die einschlägigen Transparenzpflichten gelten ab dem 2. August 2026, wie die Informationen der IHK Frankfurt zum EU AI Act erläutern.
Der Disclosure-Flow beginnt am Gesprächsanfang
Ein geeigneter Hinweis muss kurz, verständlich und hörbar sein. Er sollte nicht in juristischen Formulierungen versteckt werden. Für viele Telefonagenten gehören vier Elemente in den Gesprächsfluss:
- Identifikation: Der Anrufer erfährt, dass eine KI spricht.
- Aufgabe: Der Agent erklärt knapp, wofür er zuständig ist.
- Wahlmöglichkeit: Der Anrufer kann einen Menschen verlangen.
- Bestätigung: Bei Termin- oder Kontaktdaten wiederholt die KI die relevanten Angaben verständlich.
Die genaue Formulierung hängt vom Einsatz ab und sollte rechtlich geprüft werden. Barrierearm bedeutet hier vor allem: kurze Sätze, eindeutige Wörter, keine verschachtelten Hinweise und eine Wiederholungsmöglichkeit. Wer schlecht hört oder die Information beim Gesprächsbeginn verpasst, braucht eine faire Möglichkeit, sie erneut zu erhalten.
Weitere Einordnung und praktische Fragen zu den Anforderungen bietet die EU-AI-Act-Zusammenfassung. Sie ersetzt keine individuelle Rechtsberatung, hilft aber dabei, Transparenz als festen Bestandteil des Voice-Designs zu behandeln.
Menschlichkeit darf nicht mit Verschleierung verwechselt werden
Eine KI-Stimme darf freundlich, ruhig und kompetent klingen. Sie sollte aber nicht den Eindruck erwecken, ein bestimmter Mensch zu sein, wenn das nicht der Fall ist. Besonders sensibel ist das beim Voice-Cloning. Für die Nutzung einer geklonten Stimme müssen Einwilligung, Zweck, Nutzungsumfang und Widerrufsprozesse dokumentiert sein.
Auch die technische Kennzeichnung gehört in die Projektplanung. Dazu zählen die verwendete Stimme, die Version des Systems, die Gesprächslogik und der Zeitpunkt relevanter Änderungen. Wer diese Informationen erst im Streitfall zusammensuchen muss, hat kein belastbares Compliance-Verfahren.
Transparenz senkt nicht automatisch die Gesprächsbereitschaft. Unklare Erwartungen und ein später Vertrauensbruch tun es eher.
Die B2B-Stimme ist deshalb nicht die perfekte Imitation. Sie ist eine klar angekündigte, verständliche und begrenzte Schnittstelle, die genau weiß, was sie kann und wann sie an einen Menschen übergibt.
Integration in Voice-Agenten und Telefonie-Workflows
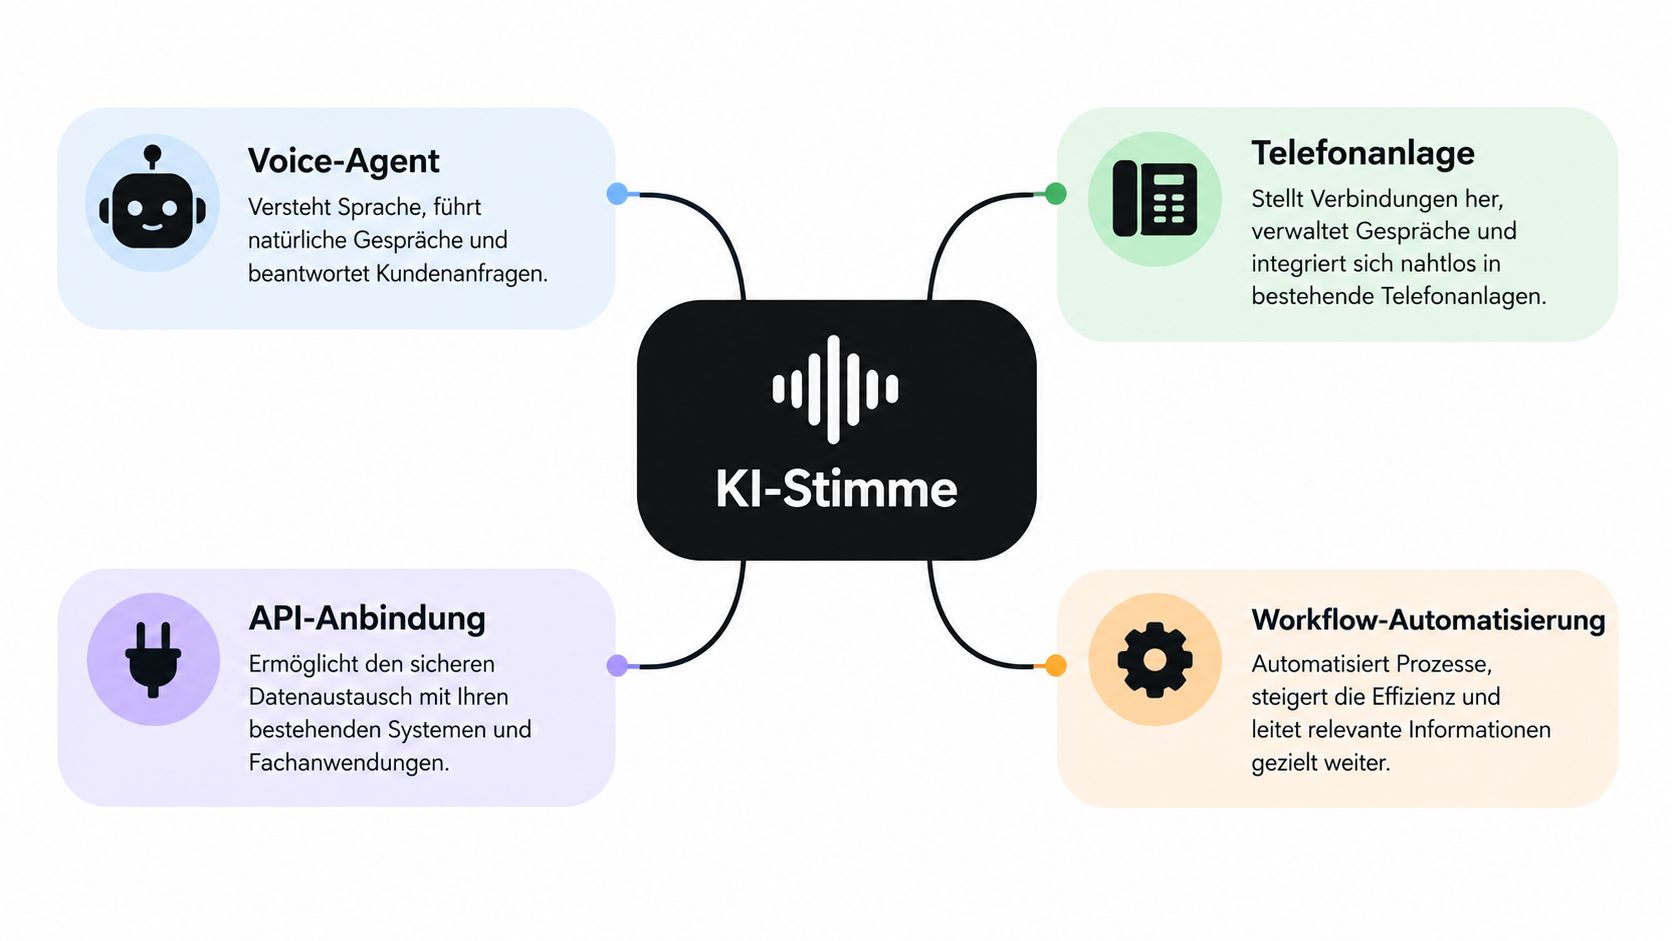
Eine gut klingende KI-Stimme rettet keinen schlecht gebauten Telefonprozess. Im produktiven Gespräch muss sie mit Gesprächslogik, Kalender, CRM und Eskalationsregeln zusammenspielen. Kennt der Agent keine aktuelle Verfügbarkeit oder übergibt einen qualifizierten Lead nicht sauber, sinkt der geschäftliche Nutzen trotz überzeugender Aussprache.
Definieren Sie die Zustände des Voice-Agenten vor dem ersten Live-Test. Auf die Begrüssung folgen Bedarfsklärung, Qualifizierung, Terminprüfung und gegebenenfalls die Übergabe. Für jeden Zustand gehören erlaubte Antworten, Rückfragen und Abbruchbedingungen in die Spezifikation. Einwände beantwortet der Agent mit geprüften Textbausteinen. Fehlt eine passende Antwort, muss eine sichere Übergabe an Mitarbeitende möglich sein.
Die Infrastruktur bestimmt die Gesprächsqualität
Eine synchronisierte Kalenderanbindung verhindert Angebote für bereits belegte Zeiten. CRM-Anbindungen wie HubSpot speichern Gesprächsergebnisse und verringern manuelle Nacharbeit. Webhooks übergeben qualifizierte Informationen an weitere Systeme. Follow-ups können aus dem Gesprächsstatus entstehen, sofern Statuswerte und Auslöser eindeutig definiert sind.
malma ist eine Option für solche Telefonie-Workflows. Die Plattform erstellt individuelle KI-Telefonagenten, stellt getestete Stimmen bereit und verbindet Voice-Agenten mit Telefonanlage, CRM- und Kalenderprozessen. Beschrieben werden unter anderem Anbindungen an HubSpot, Calendly, Google und Outlook sowie A/B-Tests für Skripte und Stimmen. Die Übersicht zum KI-Voice-Agent zeigt, wie diese Bausteine im Gespräch eingesetzt werden können.
Akzeptanz entsteht im gesamten Ablauf
Sprachinteraktion ist für viele Nutzer über verschiedene Geräte hinweg vertraut. Im B2B-Telefonvertrieb folgt daraus keine einheitliche Erwartung an jede Stimme. Anrufer bewerten vor allem Verständlichkeit, passende Antworten, erkennbare Grenzen und eine verlässliche Übergabe.
Skalieren Sie erst nach stabilen Einzelgesprächen. Testen Sie Skriptvarianten, Begrüssungen und Einwandbehandlungen getrennt voneinander. A/B-Tests vergleichen die Gesprächsführung, ohne gleichzeitig Stimme, Datenanbindung und Terminlogik zu verändern. So bleibt nachvollziehbar, welche Anpassung die Conversion oder die Übergaberate beeinflusst.
Bewerten Sie am Ende den gesamten Prozess, vom ersten Hallo bis zur sauberen CRM-Notiz oder bestätigten Übergabe.
malma.ai bietet Unternehmen individuelle KI-Telefonagenten für Lead-Qualifizierung, Terminbuchung und die Annahme eingehender Anrufe, inklusive Stimmenanpassung, Einwandbehandlung und Echtzeit-Kalender-Synchronisation. Weitere Informationen finden Sie auf malma.ai.


